クライアント: 🇭🇰 香港 · 教育系出版社
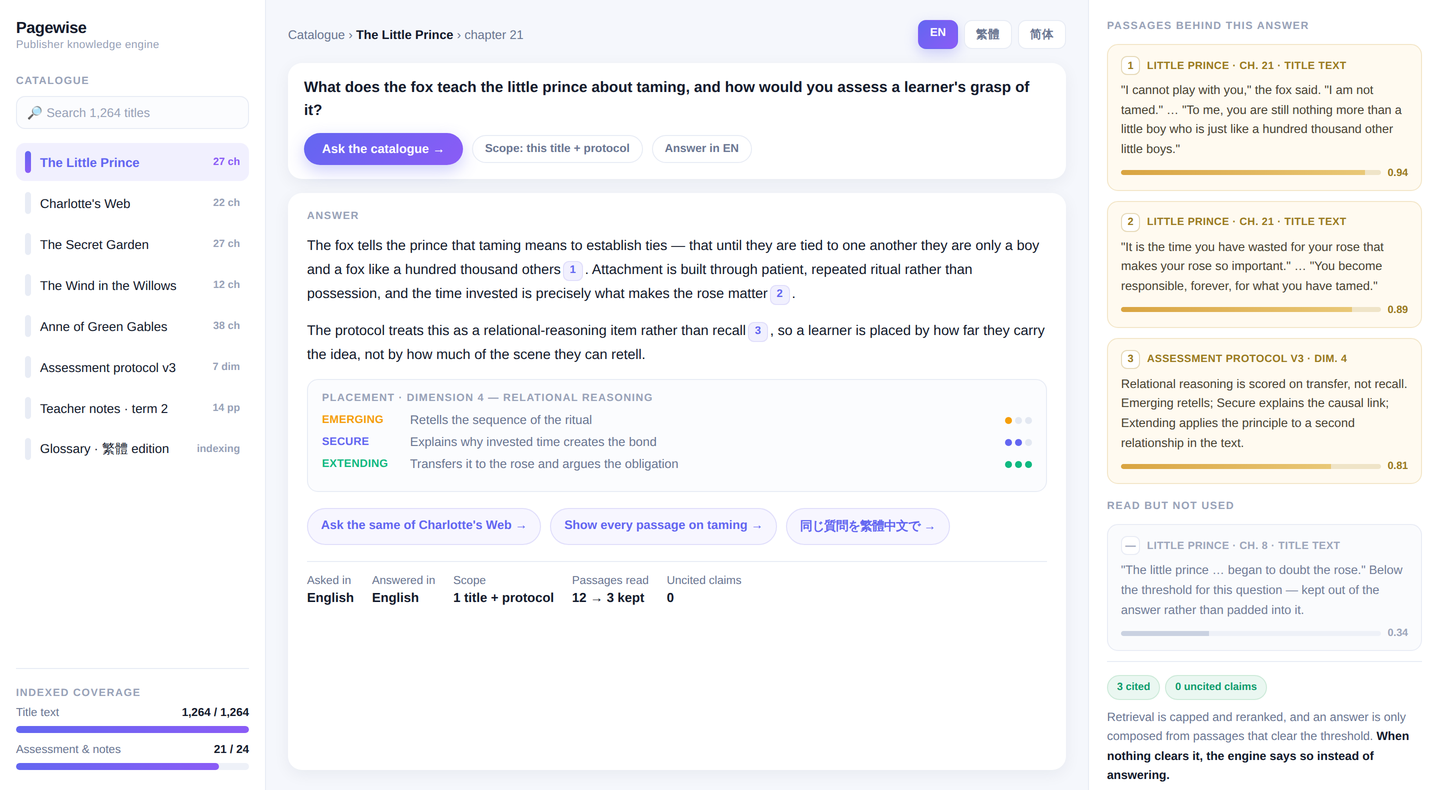
出版社向けナレッジエンジン — 蔵書カタログへの二言語Q&A
出版社が権利を持つ書籍に対して英語でも中国語でも質問でき、答えの根拠となった原文をそのまま返す検索エンジン。出典の示せない発言をさせない設計。
出版社が権利を持つ書籍に対して英語でも中国語でも質問でき、答えの根拠となった原文をそのまま返す検索エンジン。出典の示せない発言をさせない設計。
香港の教育系出版社から、自社が保有する素材—物語本文と、それに紐づく評価フレームワーク—に対して、読者・教師・社内スタッフが質問し、聞いた言語で答えが返る仕組みが欲しいという依頼。難所は文章生成ではない。答えがモデルの一般知識ではなくカタログから出ていることを担保し、それを示せるようにすることだった。
担当したのはフェーズ1。取り込みと検索のバックエンド、根拠を必ず伴う回答の契約、そして任意のフロントエンドから叩けるエンドポイント。あわせて薄い検証用画面も納品し、報告書を信じてもらうのではなく客自身がエンジンを直接叩けるようにした。
効いた制約はモデルの賢さでなく、信頼性とコストだった。検索件数に上限を設けて再ランクし、緩く一致した全部でなく密度の高い数箇所から回答を組む。1問あたりが安く済み、読み手が裏を取るのも容易になる。モデルは評判でなく実際の質問で計測して選んだ。読者が体感するのは回答までの時間だからで、数十秒かかる重量級モデルは却下し、数秒で返るものを採った。
出典フォーマットはプロンプトより先に決めた。出所を言えないなら回答は出さない—この一線が、分割の粒度も、パイプラインを通すメタデータも、APIレスポンスの形も決めている。
フェーズ1は稼働中。客はどちらの言語でも質問でき、使われた原文を目で確認できる。「この製品は何ができるのか」という話が、自社の関係者に見せられる実物に変わった。以降のフェーズ—読者向けのUIと、カタログ全体の取り込み—は同じ契約の上に乗る。
クライアント名とブランドは伏せている。掲載画面は架空ブランドと代表的なサンプルデータで、引用している原文はパブリックドメインの作品。